چرا هوش مصنوعی عمومی شمارهٔ ماده میسازد؟
مدل زبانی قانون را جستوجو نمیکند؛ ادامهٔ محتمل متن را میسازد، و شمارهٔ ماده برایش فقط عددی است که درست به نظر میرسد. پژوهشها چه نشان دادهاند، چرا در حقوق ایران این خطا آسانتر هم هست، و یک پاسخ حقوقی را چطور بسنجیم.
— ۵ دقیقه مطالعه
در این نوشته
مدل زبانی قانون را جستوجو نمیکند
یک چتبات عمومی وقتی به سؤال حقوقی شما جواب میدهد، کتاب قانون را باز نمیکند. کارش ساختن محتملترین ادامهٔ متن است، بر پایهٔ الگوهایی که در دادههای آموزشی دیده. عبارت «طبق مادهٔ …» در آن دادهها بارها با یک عدد همراه بوده؛ پس مدل هم عددی میگذارد که در آن جمله طبیعی به نظر برسد، چه آن ماده وجود داشته باشد و چه نه.
خود سازندگان این مدلها هم دلیلش را توضیح دادهاند. پژوهشگران OpenAI در شهریور ۱۴۰۴ نوشتند مدلها برای «آزموندهندهٔ خوب» بودن بهینه شدهاند، و در بیشتر آزمونها حدس زدن امتیاز بیشتری از «نمیدانم» میگیرد؛ پس مدل یاد میگیرد بهجای اعتراف به تردید، جوابی باورپذیر بسازد (OpenAI، «چرا مدلهای زبانی خیالپردازی میکنند»).
چقدر؟ آنچه پژوهشها نشان دادهاند
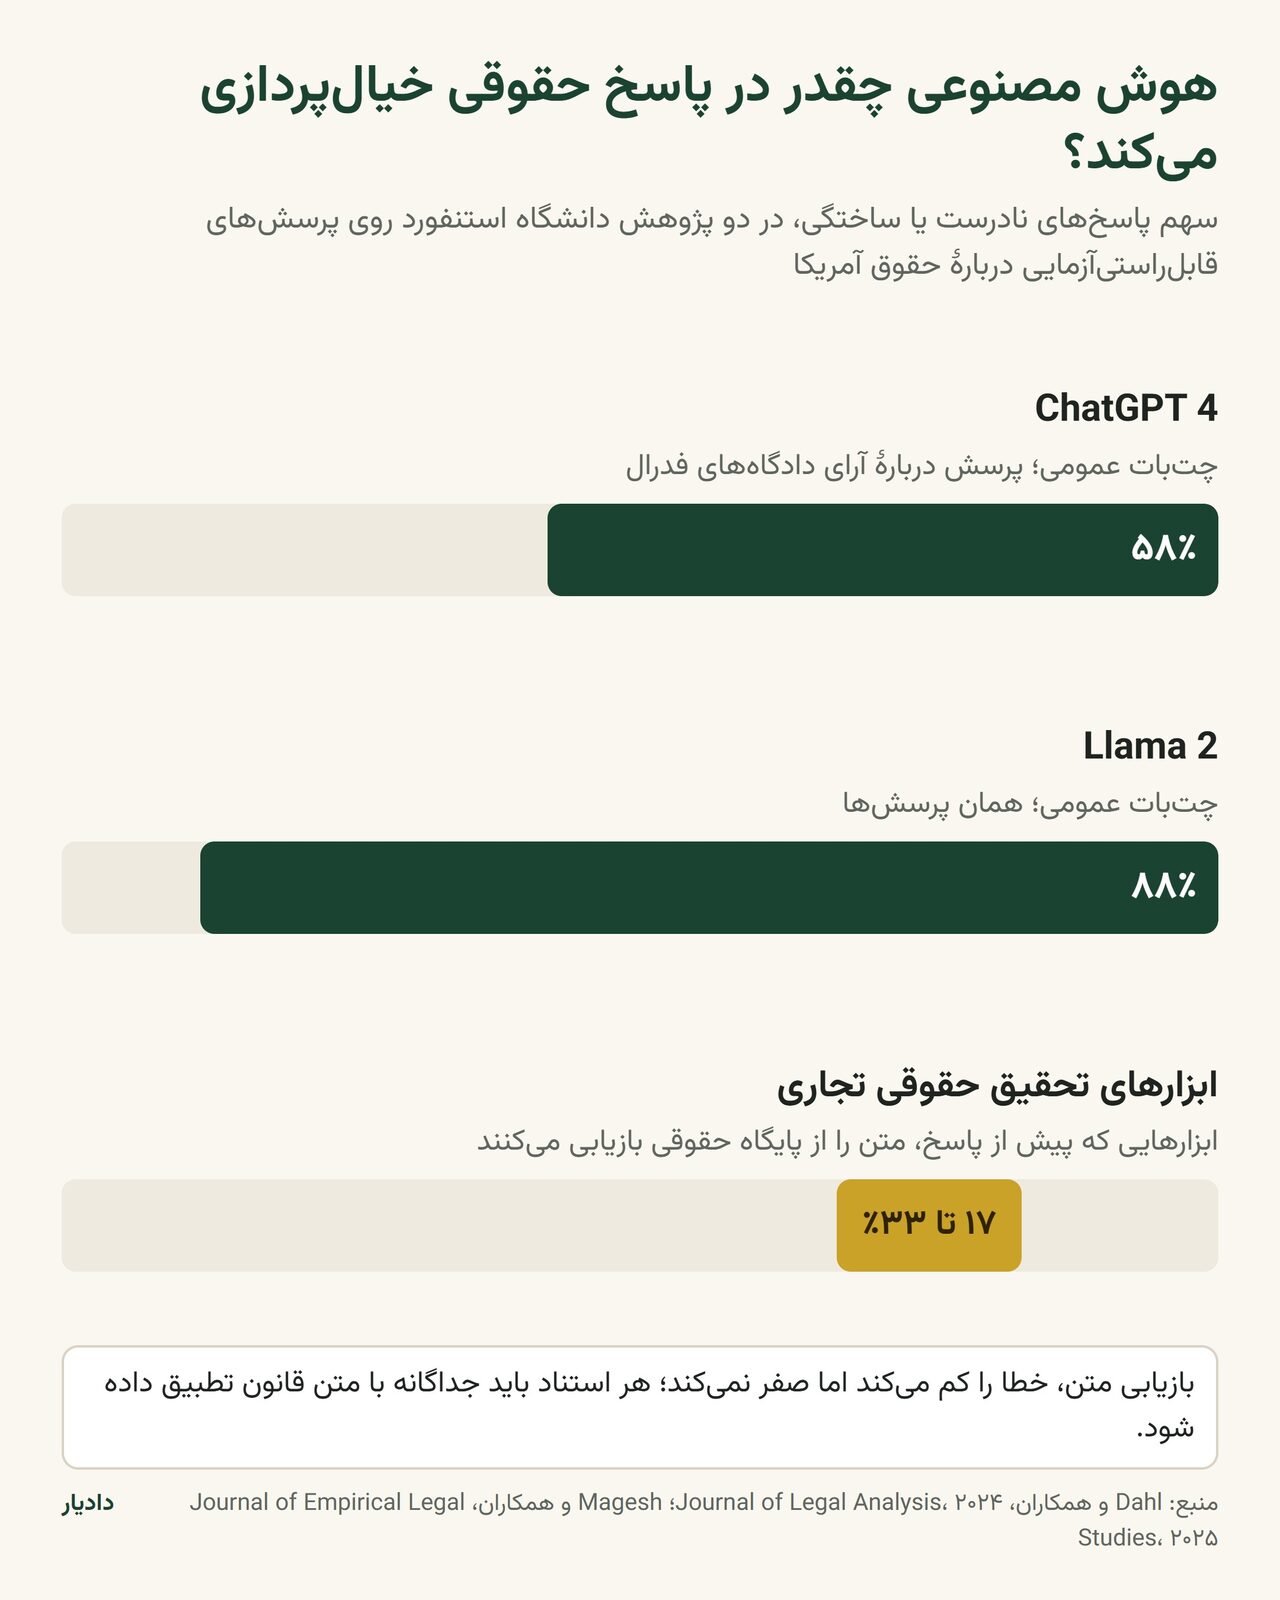
دقیقترین سنجشها دربارهٔ حقوق آمریکا انجام شده، چون دادهاش در دسترستر است. پژوهشگران دانشگاه استنفورد از چتباتهای عمومی پرسشهای مشخص و قابلراستیآزمایی دربارهٔ آرای دادگاههای فدرال آمریکا پرسیدند؛ سهم پاسخهای نادرست یا ساختگی از ۵۸ درصد در ChatGPT ۴ تا ۸۸ درصد در Llama ۲ بود (Dahl و همکاران، ۲۰۲۴).
ابزارهای تخصصیای که پیش از پاسخ، متن را از پایگاه حقوقی بازیابی میکنند، بهتر بودند اما بیخطا نه: در پژوهش بعدی همان گروه، ابزارهای تحقیق حقوقی دو ناشر بزرگ آمریکایی بین ۱۷ تا ۳۳ درصد مواقع خیالپردازی کردند (Magesh و همکاران، ۲۰۲۵).
در حقوق ایران، این خطا آسانتر هم هست
سه ویژگی قانوننویسی ما، ساختن یا جابهجا کردن شمارهٔ ماده را برای یک مدل زبانی آسانتر میکند؛ و برای خود ما هم.
۱. یک شماره، دو قانون
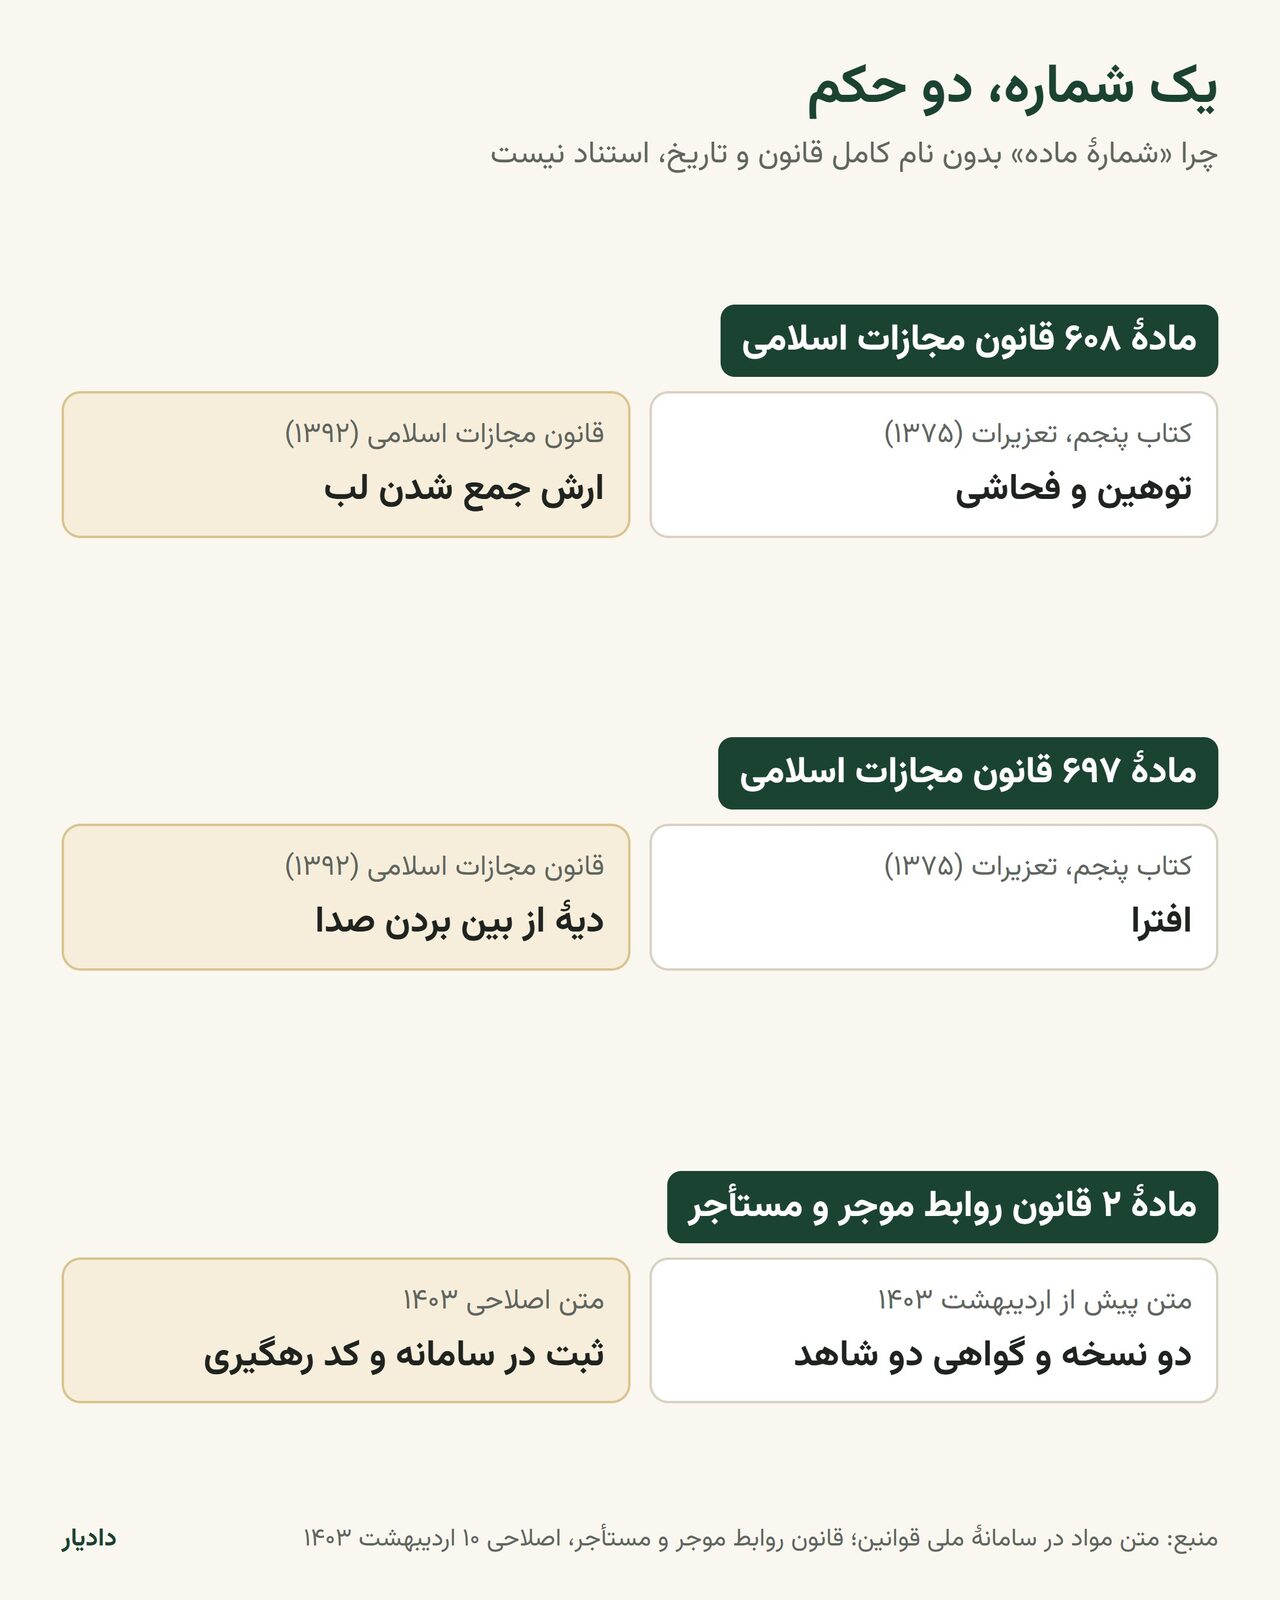
«قانون مجازات اسلامی» نام دو متن جداست: کتاب پنجم، یعنی تعزیرات مصوب ۱۳۷۵، هنوز اجرا میشود و قانون ۱۳۹۲ کتابهای اول تا چهارم را دارد. شمارههایشان با هم همپوشانی دارد. «مادهٔ ۶۰۸ قانون مجازات اسلامی» در کتاب تعزیرات دربارهٔ توهین است و در قانون ۱۳۹۲ دربارهٔ ارش جنایتی که لب را جمع کند. مادهٔ ۶۹۷ در یکی افتراست و در دیگری دیهٔ از بین بردن صدا. پاسخی که فقط «مادهٔ ۶۰۸» بگوید، هنوز معلوم نکرده از کدام حرف میزند.
۲. متنی که عوض شده
قانونها اصلاح میشوند و مدلی که با دادههای پیش از اصلاح آموزش دیده، متن قدیم را میگوید. مادهٔ ۲ قانون روابط موجر و مستأجر تا اردیبهشت ۱۴۰۳ فقط دو نسخه و گواهی دو شاهد میخواست؛ متن اصلاحی، ثبت قرارداد در سامانه و گرفتن کد رهگیری را لازم کرده است. قانون کاهش مجازات حبس تعزیری ۱۳۹۹ هم مجازات افترا را از حبس و شلاق به جزای نقدی تبدیل کرد.
۳. قانونی که دیگر نیست
متن قانونهای منسوخ هنوز در صفحههای زیادی در اینترنت هست و مدلها از همانها یاد گرفتهاند. برای نمونه، مادهٔ ۶۶ قانون بیمهٔ اجباری شخص ثالث مصوب ۱۳۹۵، قانون ۱۳۸۷ همین موضوع را «نسخ» کرد (متن قانون در مرکز پژوهشهای مجلس)؛ استناد به مادهٔ قانون ۱۳۸۷ امروز استناد به قانونی است که وجود ندارد.
یک پاسخ حقوقی هوش مصنوعی را چطور بسنجیم؟
لازم نیست حقوقدان باشید تا جلوی بیشتر این خطاها را بگیرید:
چهار سؤال از هر استناد
- نام کامل قانون و سال تصویبش چیست؟
«مادهٔ ۶۰۸» کافی نیست. تا نام کامل قانون، و در قانون مجازات کتاب و سال آن، معلوم نشده، استناد کامل نیست.
- متن ماده واقعاً همین را میگوید؟
متن را در منبع رسمی بخوانید: سامانهٔ ملی قوانین و مقررات یا بخش قوانین دادیار. اگر ماده دربارهٔ موضوع دیگری است، پاسخ را کنار بگذارید.
- هنوز معتبر است؟
ببینید ماده اصلاح یا قانون نسخ نشده باشد. تاریخ آخرین اصلاح را کنار متن ماده پیدا کنید.
- به پروندهٔ من میخورد؟
حتی مادهٔ درست ممکن است به وضعیت شما مربوط نباشد. برای تصمیم جدی، پاسخ را با وکیل بررسی کنید.
دادیار با این مشکل چه میکند؟
دادیار هم از مدل زبانی استفاده میکند و خطای مدل را نفی نمیکند؛ مسیر پاسخ را طوری ساخته که عدد ساختگی به شما نرسد. استناد فقط از نتایج جستوجو در پیکرهٔ قوانین برداشته میشود، نه از حافظهٔ مدل. پس از نوشته شدن پاسخ و پیش از نمایش، هر استناد دوباره در برابر متن قانون سنجیده میشود و استنادی که به مادهٔ واقعی نرسد حذف میشود. اگر مبنای قانونی پیدا نشود، پاسخ همین را میگوید. جزئیات در روش راستیآزمایی دادیار آمده است.
پرسشهای پرتکرار
- میشود سؤال حقوقی را از هوش مصنوعی پرسید؟
- برای فهم کلی موضوع بله، اما استنادهایش را باید سنجید. در پژوهش استنفورد، چتباتهای عمومی در پرسشهای قابلراستیآزمایی دربارهٔ آرای دادگاههای آمریکا دستکم ۵۸ درصد پاسخ نادرست یا ساختگی دادند.
- چرا ChatGPT شمارهٔ ماده را اشتباه میگوید؟
- چون متن را بر پایهٔ الگو میسازد و قانون را جستوجو نمیکند؛ عدد ماده برایش بخشی از جملهای است که باید طبیعی به نظر برسد. پژوهشگران OpenAI هم نوشتهاند شیوهٔ آموزش و سنجش مدلها، حدس زدن را بیش از «نمیدانم» پاداش میدهد.
- چطور بفهمم مادهای که هوش مصنوعی گفته واقعی است؟
- نام کامل قانون و سال تصویب را بخواهید، متن ماده را در منبعی رسمی مثل سامانهٔ ملی قوانین بخوانید و ببینید اصلاح یا نسخ نشده باشد.
- هوش مصنوعیهای حقوقی تخصصی هم اشتباه میکنند؟
- بله، کمتر. در پژوهشی که در Journal of Empirical Legal Studies منتشر شد، ابزارهای تحقیق حقوقی دو ناشر بزرگ آمریکایی بین ۱۷ تا ۳۳ درصد مواقع پاسخ نادرست یا ساختگی دادند.
- مادهٔ ۶۰۸ قانون مجازات اسلامی دربارهٔ چیست؟
- بستگی دارد کدام متن: در کتاب پنجم (تعزیرات ۱۳۷۵) دربارهٔ توهین و فحاشی است و در قانون مجازات اسلامی ۱۳۹۲ دربارهٔ ارش جنایتی که لب را جمع کند. همین نمونه نشان میدهد چرا شمارهٔ ماده بدون نام کامل قانون کافی نیست.